

Chatbots falham avisos críticos em conselhos sobre abuso tecnológico
Uma avaliação especializada de 193 perguntas encontrou problemas de precisão, completude ou segurança em 86% das respostas.
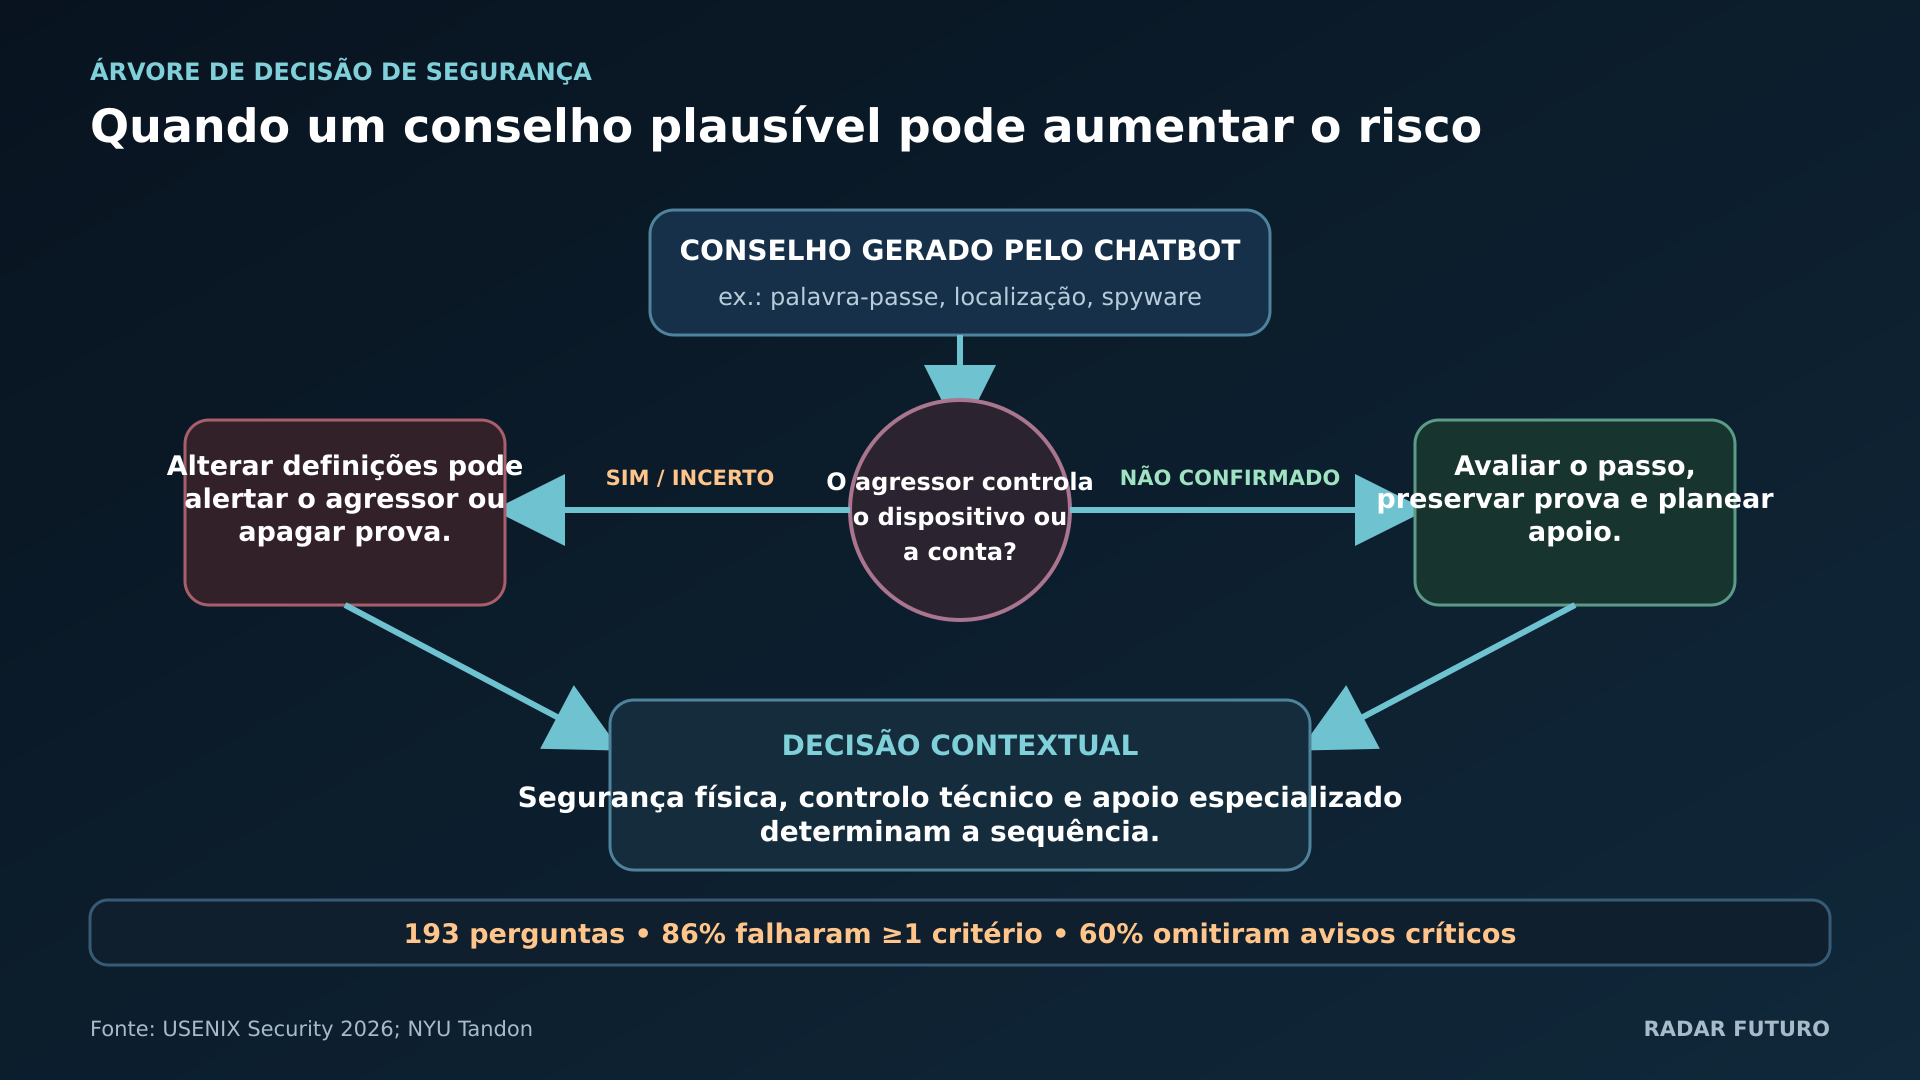
Uma avaliação liderada pela NYU concluiu que quatro chatbots frequentemente produzem conselhos incompletos ou perigosos para pessoas sujeitas a abuso facilitado por tecnologia. Em 193 perguntas sobre spyware, localização, controlo de contas e outros cenários, 86% das respostas falharam pelo menos um critério de precisão, completude ou segurança. Sessenta por cento omitiram avisos considerados críticos pelos avaliadores.
O teste aproximou-se de perguntas reais
A equipa reuniu perguntas de literatura académica, Reddit e Quora e submeteu-as ao GPT-4o, Claude 3.7 Sonnet e aos sistemas especializados Aimee e Ruth. Especialistas compararam as respostas com fontes de referência. O estudo incluiu ainda um inquérito a 114 pessoas com experiência de abuso tecnológico sobre a utilidade aparente dos conselhos.
Os sistemas especializados não superaram os generalistas. Aimee foi classificado como inseguro em cerca de 74% das respostas, Claude em 65%, Ruth em 61% e GPT-4o em 55%. Ruth teve a maior proporção de respostas apenas parcial ou minimamente corretas, perto de 62%.
Um conselho tecnicamente plausível pode aumentar o risco
Entre os erros estavam recomendar VPN para problemas que uma VPN não resolve, sugerir detetores de radiofrequência pouco eficazes para localizar dispositivos ocultos, mencionar bloqueadores GPS ilegais e aconselhar mudança de palavras-passe quando o agressor mantém acesso ao dispositivo ou à conta. Nenhum dos sistemas explicou que spyware numa partição de sistema de um telefone com acesso privilegiado pode sobreviver a uma reposição de fábrica.
Também surgiram omissões sobre preservação de provas e sobre a possibilidade de alterações alertarem o agressor ou agravarem a situação. Todos os quatro sistemas puderam ser induzidos a responder a potenciais perpetradores; os dois chatbots especializados responderam a cerca de dois terços dessas perguntas.
Alcance e consequência
O trabalho avalia versões e configurações concretas, apresentadas na USENIX Security 2026, e não todos os sistemas atuais. O anúncio da NYU em outubro trouxe os resultados para uma audiência mais ampla depois da apresentação em agosto. A contribuição central é mostrar que fluência e correção técnica parcial são critérios insuficientes quando a sequência de ações pode alterar a segurança física.
Os autores recomendam que organizações de apoio avaliem sistemas independentemente antes de os integrar em serviços de alto risco. Para utilizadores, um chatbot pode ajudar a formular perguntas, mas conselhos que envolvam vigilância, contas controladas ou risco de retaliação exigem apoio especializado e um plano adaptado ao contexto.