

CheMeleon prevê propriedades de moléculas quando existem poucos dados experimentais
O modelo aprende 1600 descritores calculáveis em cerca de um milhão de moléculas e foi comparado em 58 tarefas. Serve para priorizar experiências, não para substituir validação laboratorial.
Investigadores do MIT e da BASF desenvolveram o CheMeleon, um modelo de aprendizagem automática concebido para prever propriedades moleculares quando existem poucos resultados experimentais. Segundo o MIT, o artigo foi publicado a 14 de setembro no Journal of Chemical Information and Modeling; a divulgação do MIT ocorreu em 6 de novembro.
Aprender química sem recolher toda a literatura
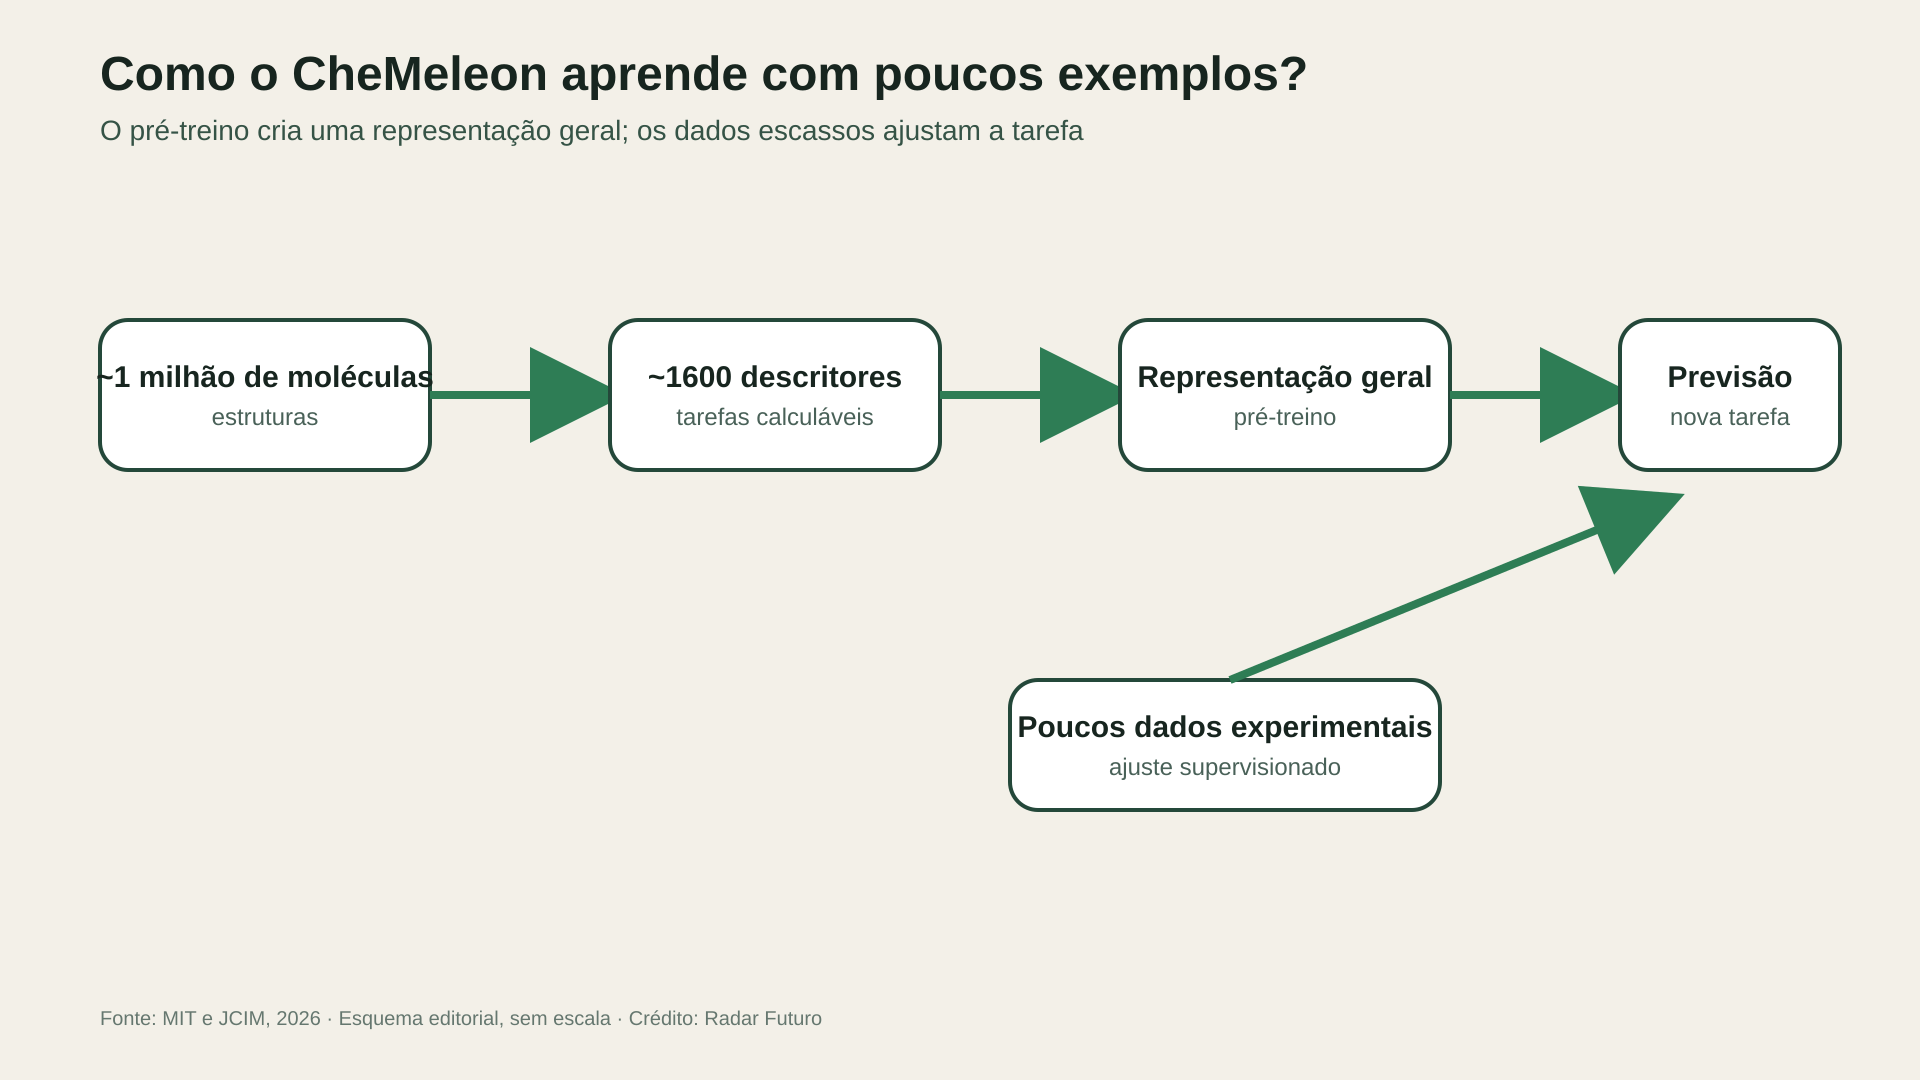
O sistema foi pré-treinado com cerca de um milhão de moléculas do PubChem. Para cada estrutura, o treino procurou prever aproximadamente 1600 descritores calculáveis, como massa molecular, número de átomos de oxigénio ou características de forma. Esta tarefa fornece uma representação geral que depois pode ser ajustada para solubilidade, toxicidade, atividade biológica ou reatividade.
A estratégia evita depender de grandes conjuntos de resultados experimentais para cada propriedade. Também difere de modelos treinados diretamente sobre texto científico: o conhecimento inicial vem de estruturas e descritores químicos calculados.
O que os testes mostram
Os autores compararam o CheMeleon com outros modelos de base e com métodos clássicos orientados por descritores em 58 casos de teste. Segundo o artigo e a síntese do MIT, o novo modelo obteve o melhor desempenho no conjunto dessas comparações, sobretudo quando os dados de ajuste eram escassos.
O modelo tem cerca de dez milhões de parâmetros e integra o pacote aberto ChemProp. Num concurso da OpenADMET realizado em 2026, nove das vinte melhores submissões usaram o CheMeleon em parte do processo. Esse resultado mostra adoção e utilidade competitiva, embora não isole o contributo do modelo em cada sistema completo.
Onde o ganho é prático
Na descoberta de fármacos ou materiais, sintetizar e testar moléculas é caro. Um modelo mais robusto com poucos exemplos pode reduzir a lista inicial e concentrar experiências nos candidatos mais promissores. O resultado útil é a priorização: cada previsão continua a precisar de síntese, medição e controlo experimental.
O estudo avaliou benchmarks conhecidos. Desempenho médio superior não garante a mesma vantagem em todas as famílias químicas, propriedades ou condições de laboratório. A qualidade dos poucos dados usados no ajuste e a distância entre as novas moléculas e o conjunto de treino continuam a importar.
O que se pode concluir
O trabalho demonstra que descritores químicos clássicos podem servir como tarefa de pré-treino para uma rede neuronal e melhorar previsões em cenários de poucos dados. O próximo passo é medir o ganho em campanhas prospetivas, onde o modelo escolhe moléculas ainda não testadas e o laboratório confirma quantas previsões conduzem a candidatos úteis.