

Teste MKA põe agentes de IA a trabalhar com ficheiros visuais de dez setores
A avaliação usa 200 tarefas privadas e publica dez exemplos separados. A grelha dá maior peso à correção factual.
A Google e a Artificial Analysis apresentaram em 10 de novembro o Multimodal Knowledge Agent (MKA), uma avaliação em que os agentes têm de interpretar ficheiros e entregar um produto de trabalho. O conjunto de 200 tarefas foi desenvolvido com especialistas de dez setores e 83 ocupações. Uma tarefa pode combinar documentos visuais e dados tabulares e exigir uma apresentação, um relatório ou uma folha de cálculo.
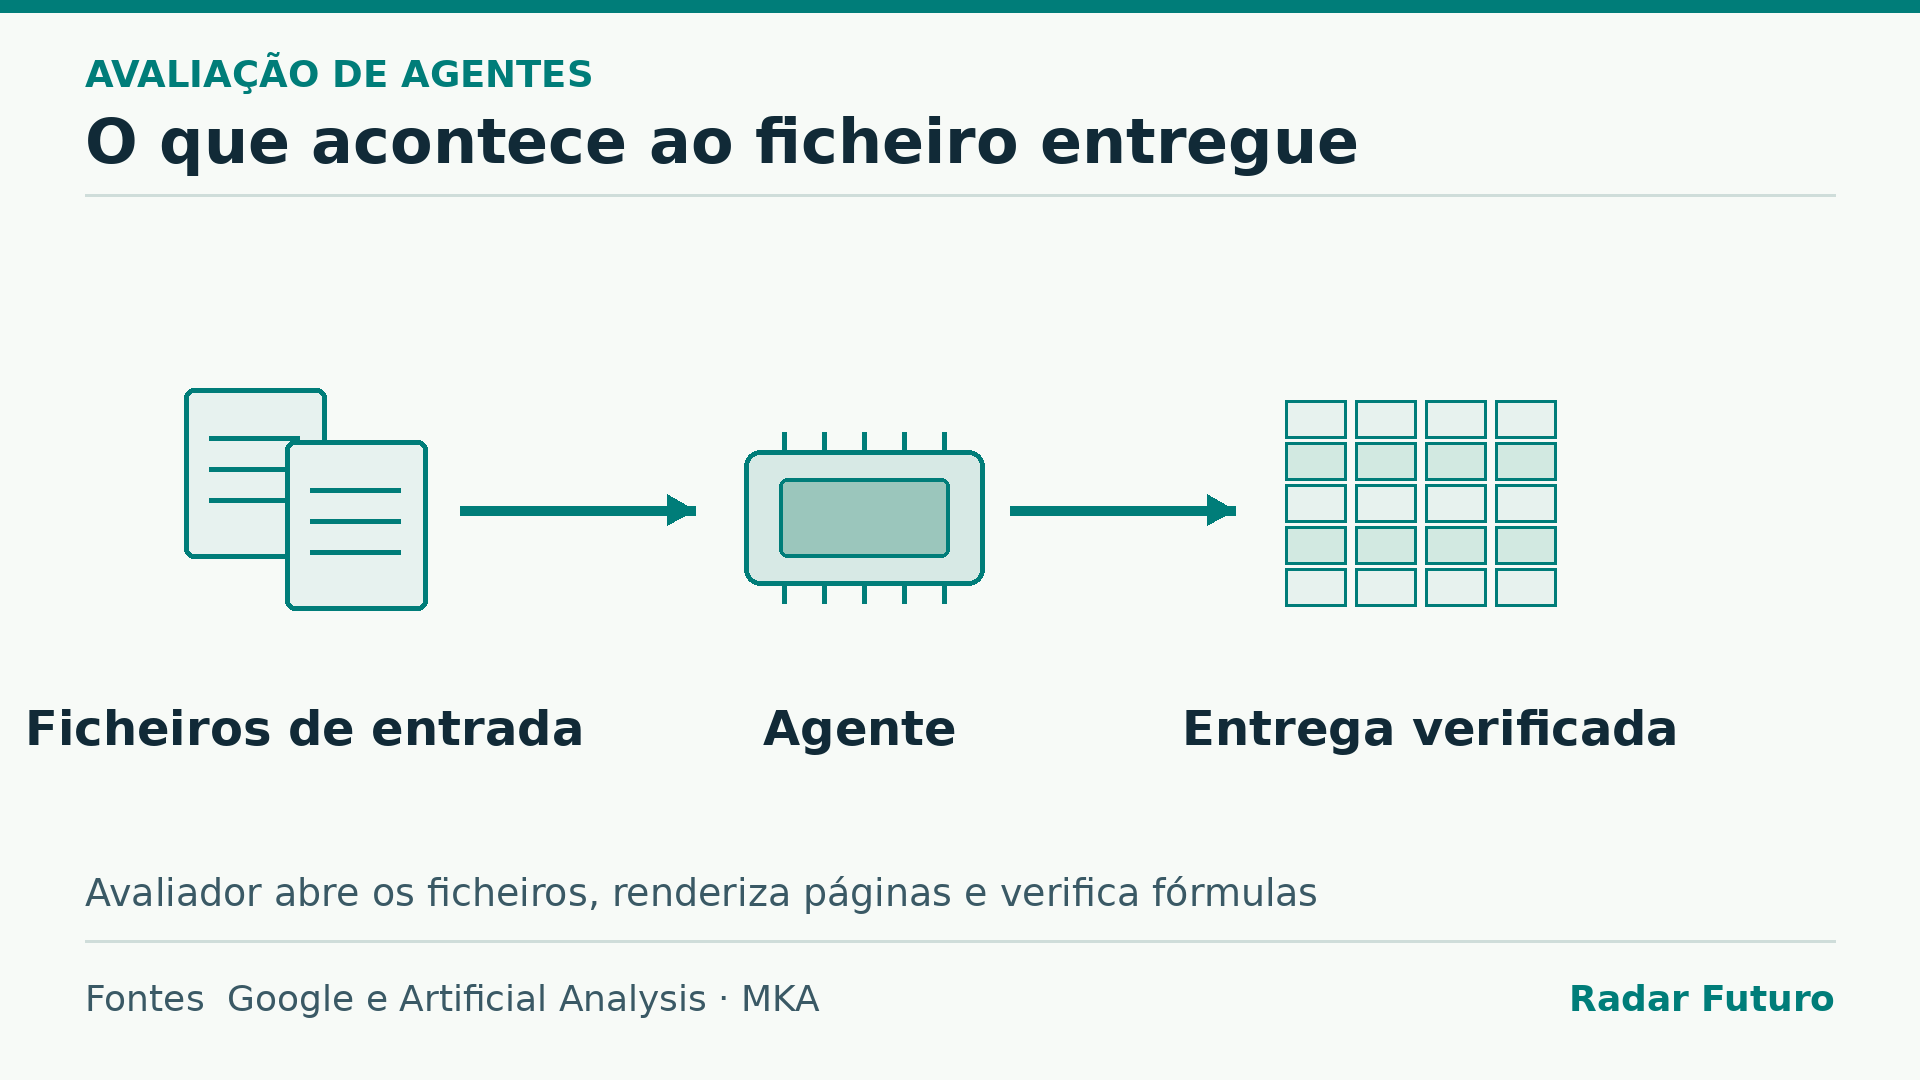
A grelha de cada tarefa tem cerca de 70 verificações binárias. Segundo a metodologia publicada, 75% do peso recai sobre a correção factual e 25% sobre o desenho visual. O avaliador automático abre os ficheiros, renderiza páginas e inspeciona fórmulas. A Google reporta uma concordância de 96% com especialistas nas classificações que estes também fizeram. Esse valor diz respeito à concordância do avaliador, uma medida distinta do desempenho dos modelos.
Os modelos foram executados com as mesmas ferramentas, ambiente isolado e orçamento de interações. A equipa reportou médias de cerca de 30 a 130 interações por tarefa, conforme o modelo. A diferença dá contexto ao custo de produzir uma entrega, que depende do percurso completo e da quantidade de trabalho que precisa de revisão.
A Artificial Analysis mantém privadas as 200 tarefas usadas na avaliação para reduzir a possibilidade de os modelos as encontrarem durante o treino ou uma pesquisa. Os dez exemplos públicos permitem inspecionar o formato. O desempenho observado descreve o conjunto, o ambiente e a grelha adotados. Uma equipa que queira usar um agente nos seus próprios ficheiros terá de testar os erros que mais pesam no seu fluxo, como uma fórmula incorreta que o aspeto final da folha não revela.