

Google separa computação confidencial e largura de banda em duas novas TPU
A TPU 8tx estende o isolamento por hardware aos aceleradores. A 8i Max duplica a largura de banda HBM face à 8i.
A Google Cloud anunciou em 9 de novembro duas configurações de aceleradores de IA. A TPU 8tx destina-se a proteger dados e parâmetros do modelo durante a execução. A TPU 8i Max procura alimentar o acelerador com mais dados por unidade de tempo. Os dois sistemas ilustram como os limites da inferência mudam conforme o trabalho.
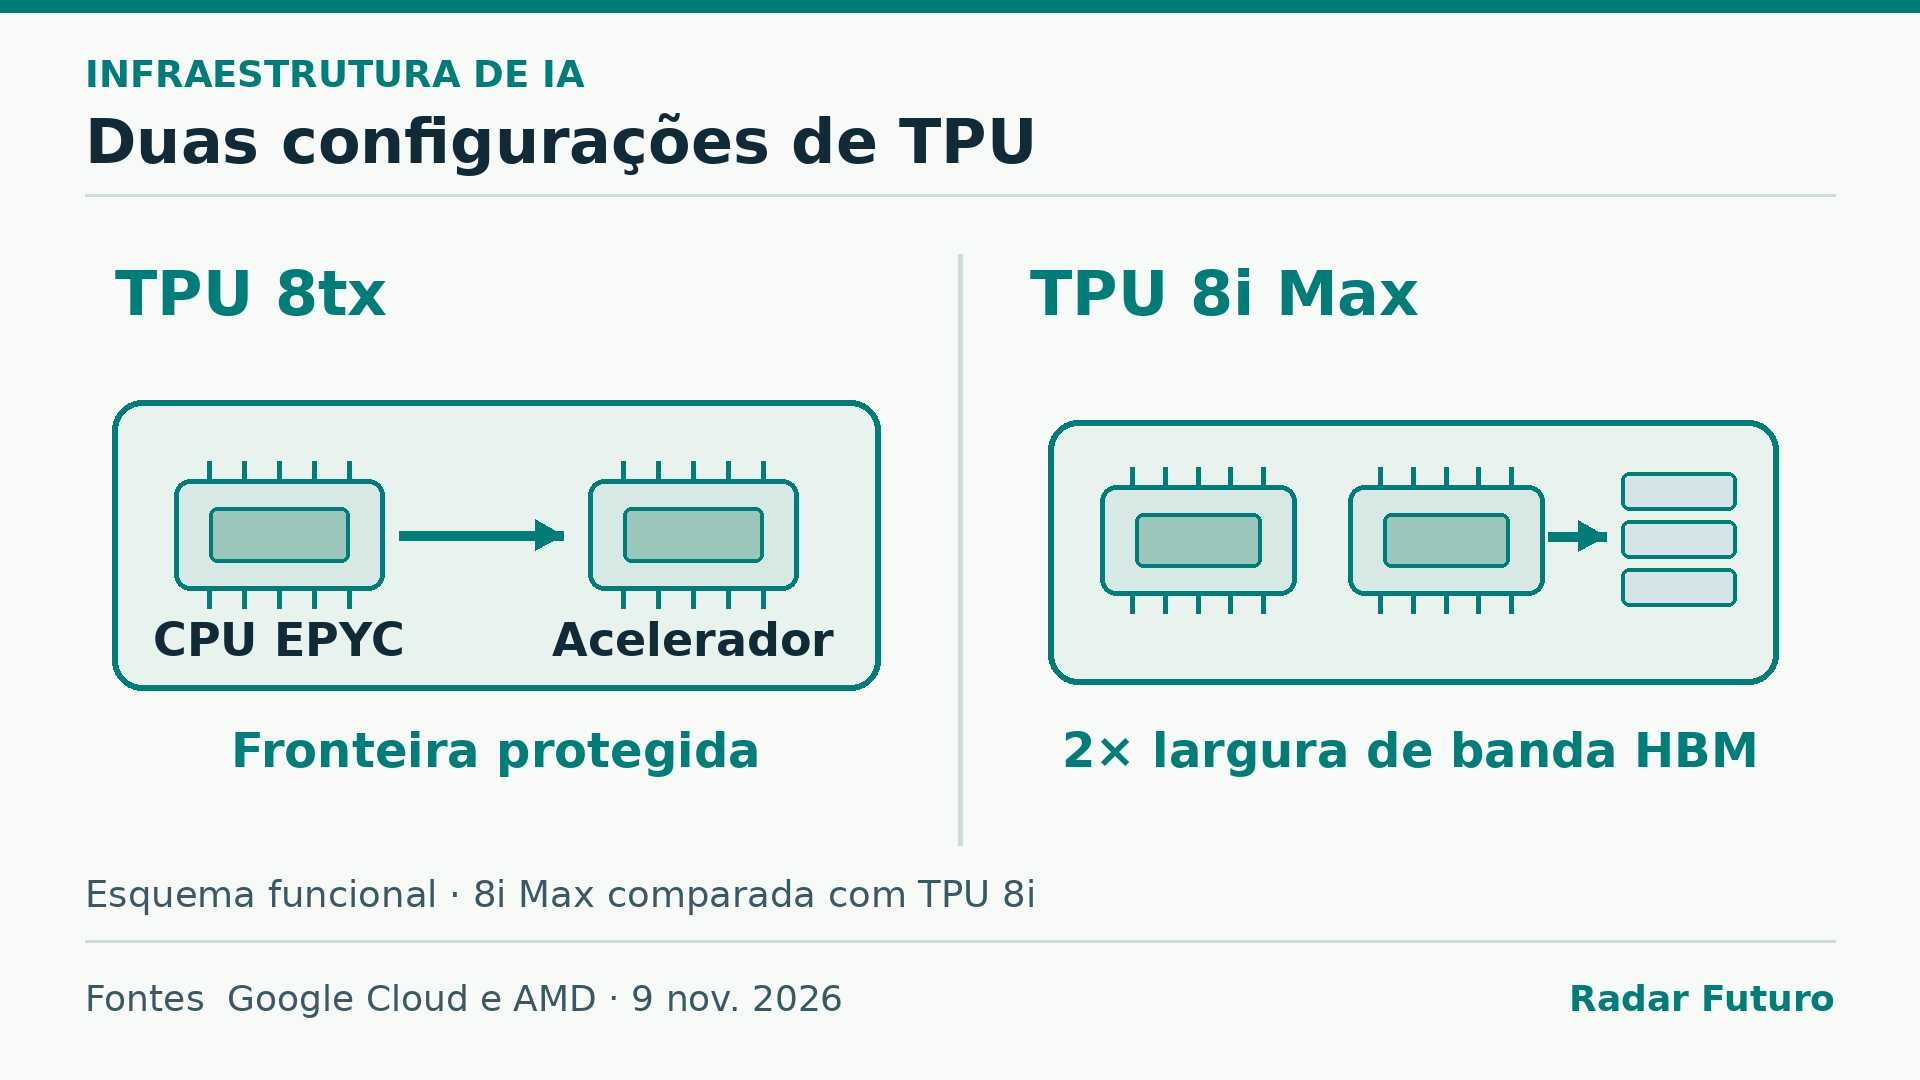
Na 8tx, a CPU anfitriã AMD EPYC de quinta geração prepara dados e coordena a carga. A AMD descreve uma etapa de verificação da identidade e da configuração do acelerador antes de este aceder à memória protegida. A proteção combina memória da CPU e comunicações cifradas com isolamento por hardware durante a execução no acelerador. Esta fronteira interessa quando os dados submetidos ao modelo ou os seus parâmetros são sensíveis.
O desenho reaproveita o silício da TPU 8t. A Google acrescenta a rede Boardfly e anuncia uma latência que pode descer até metade da registada na 8t. O máximo reportado pertence à comparação do fornecedor. A latência de uma aplicação inteira também depende das transferências, do tamanho do pedido e da forma como a carga é distribuída.
Na TPU 8i Max, dois chips 8i passam a partilhar o mesmo encapsulamento. Face à TPU 8i, a Google anuncia o dobro da capacidade de cálculo, da memória SRAM e da largura de banda da memória HBM, mantendo a área ocupada pelo bastidor. Mais largura de banda permite mover dados mais depressa. Numa carga que já espera pela memória, acrescentar apenas unidades de cálculo poderia deixar parte delas ociosa.
A descrição pública estabelece duas escolhas de arquitetura. Para uma organização que avalie a 8tx, a verificação relevante é a cadeia de confiança entre anfitrião e acelerador. Para uma carga de contexto longo na 8i Max, a comparação útil é entre o rendimento e a latência obtidos com a mesma carga, incluindo o consumo da infraestrutura que a suporta.
Leitura relacionada
Como a NVIDIA e os parceiros coreanos planeiam ligar GPU e NPU