

GPT-6 Sol e Luna chegam com uma aposta clara: mais capacidade por menos custo
A OpenAI separa a nova geração em dois perfis: Sol procura equilibrar capacidade e preço; Luna reduz o custo para tarefas de grande volume.
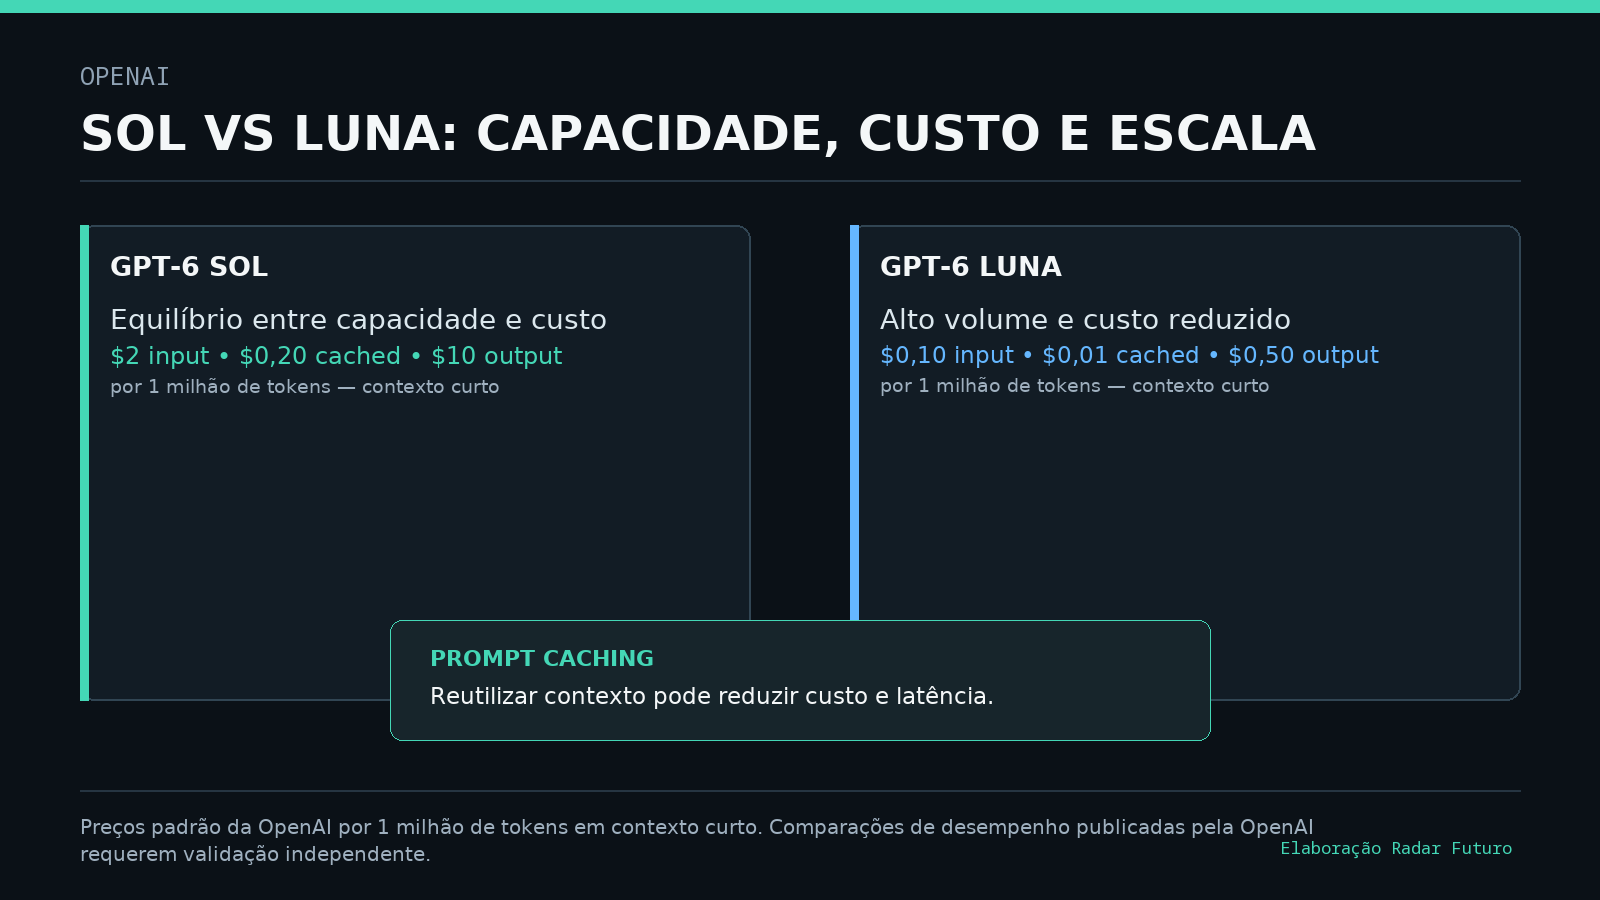
A OpenAI apresentou dois modelos com nomes solares, mas a diferença decisiva está menos na marca do que na economia de utilização. O GPT-6 Sol é posicionado como o modelo de equilíbrio entre capacidade e custo. O GPT-6 Luna foi desenhado para processar muito volume com um preço unitário mais baixo.
Nos preços publicados para contextos curtos, o Sol custa 2 dólares por um milhão de tokens de entrada, 0,20 dólares por entrada em cache e 10 dólares por saída. No Luna, os mesmos valores descem para 0,10, 0,01 e 0,50 dólares. A relação é de vinte para um em cada parcela, uma distância que permite atribuir papéis muito diferentes aos dois modelos.
A empresa diz ter reduzido os preços face ao GPT-5.6 e melhorado o funcionamento do prompt caching. Isso importa porque muitas aplicações repetem instruções, documentos ou históricos entre pedidos: quando esse contexto pode ser reutilizado a partir de cache, deixa de ser cobrado ao preço integral de entrada e pode também reduzir a latência.
O custo muda a arquitetura das aplicações
Uma equipa não escolhe necessariamente um único modelo para tudo. Tarefas que exigem análise mais exigente podem ser encaminhadas para o Sol, enquanto classificações, extrações simples, reformatação ou operações repetitivas podem caber ao Luna. A poupança depende, por isso, da distribuição real do trabalho e não apenas do preço anunciado numa tabela.
O custo por token também não equivale ao custo por resultado útil. Um modelo mais barato pode precisar de mais tentativas, instruções maiores ou revisão humana; um modelo mais caro pode resolver uma tarefa com menos passos. Só testes com dados e critérios próprios permitem perceber qual é a opção mais económica em produção.
Desempenho ainda por verificar
A OpenAI acompanha o lançamento com comparações de desempenho e afirmações de eficiência. Esses resultados devem ser lidos como benchmarks do fabricante, não como validação independente. Conjuntos de testes públicos ajudam a comparar modelos, mas não reproduzem automaticamente os erros, os idiomas e os riscos de cada aplicação.
Há ainda uma distinção importante entre melhoria média e fiabilidade. Mesmo quando uma métrica sobe, respostas factualmente erradas, instruções mal interpretadas ou código defeituoso continuam possíveis. Para usos sensíveis, a redução de preço não substitui avaliação, monitorização e revisão humana.
O que observar a seguir
A adoção mostrará se a divisão entre um modelo geral e outro de escala se traduz em sistemas mais eficientes. Será relevante acompanhar avaliações externas, desempenho em português, limites de contexto, latência real e a forma como o cache se comporta em fluxos longos. Também importa comparar o custo total, incluindo ferramentas, armazenamento e controlo de qualidade.
O anúncio aponta para uma mudança mais ampla: a concorrência em inteligência artificial já não se mede apenas pela capacidade máxima. Preço, previsibilidade e capacidade de encaminhar cada tarefa para o nível certo começam a determinar quais produtos são viáveis.