

Carbon-X junta DNA e linguagem num modelo aberto que pode correr localmente
O modelo de 14,8 mil milhões de parâmetros lê sequências em blocos de seis bases e responde em linguagem natural.
A Hugging Face publicou o Carbon-X, um modelo aberto de 14,8 mil milhões de parâmetros treinado em sequências de DNA e texto. O utilizador pode inserir uma sequência numa conversa e pedir uma previsão ou explicação em inglês. Os pesos são distribuídos sob licença Apache 2.0.
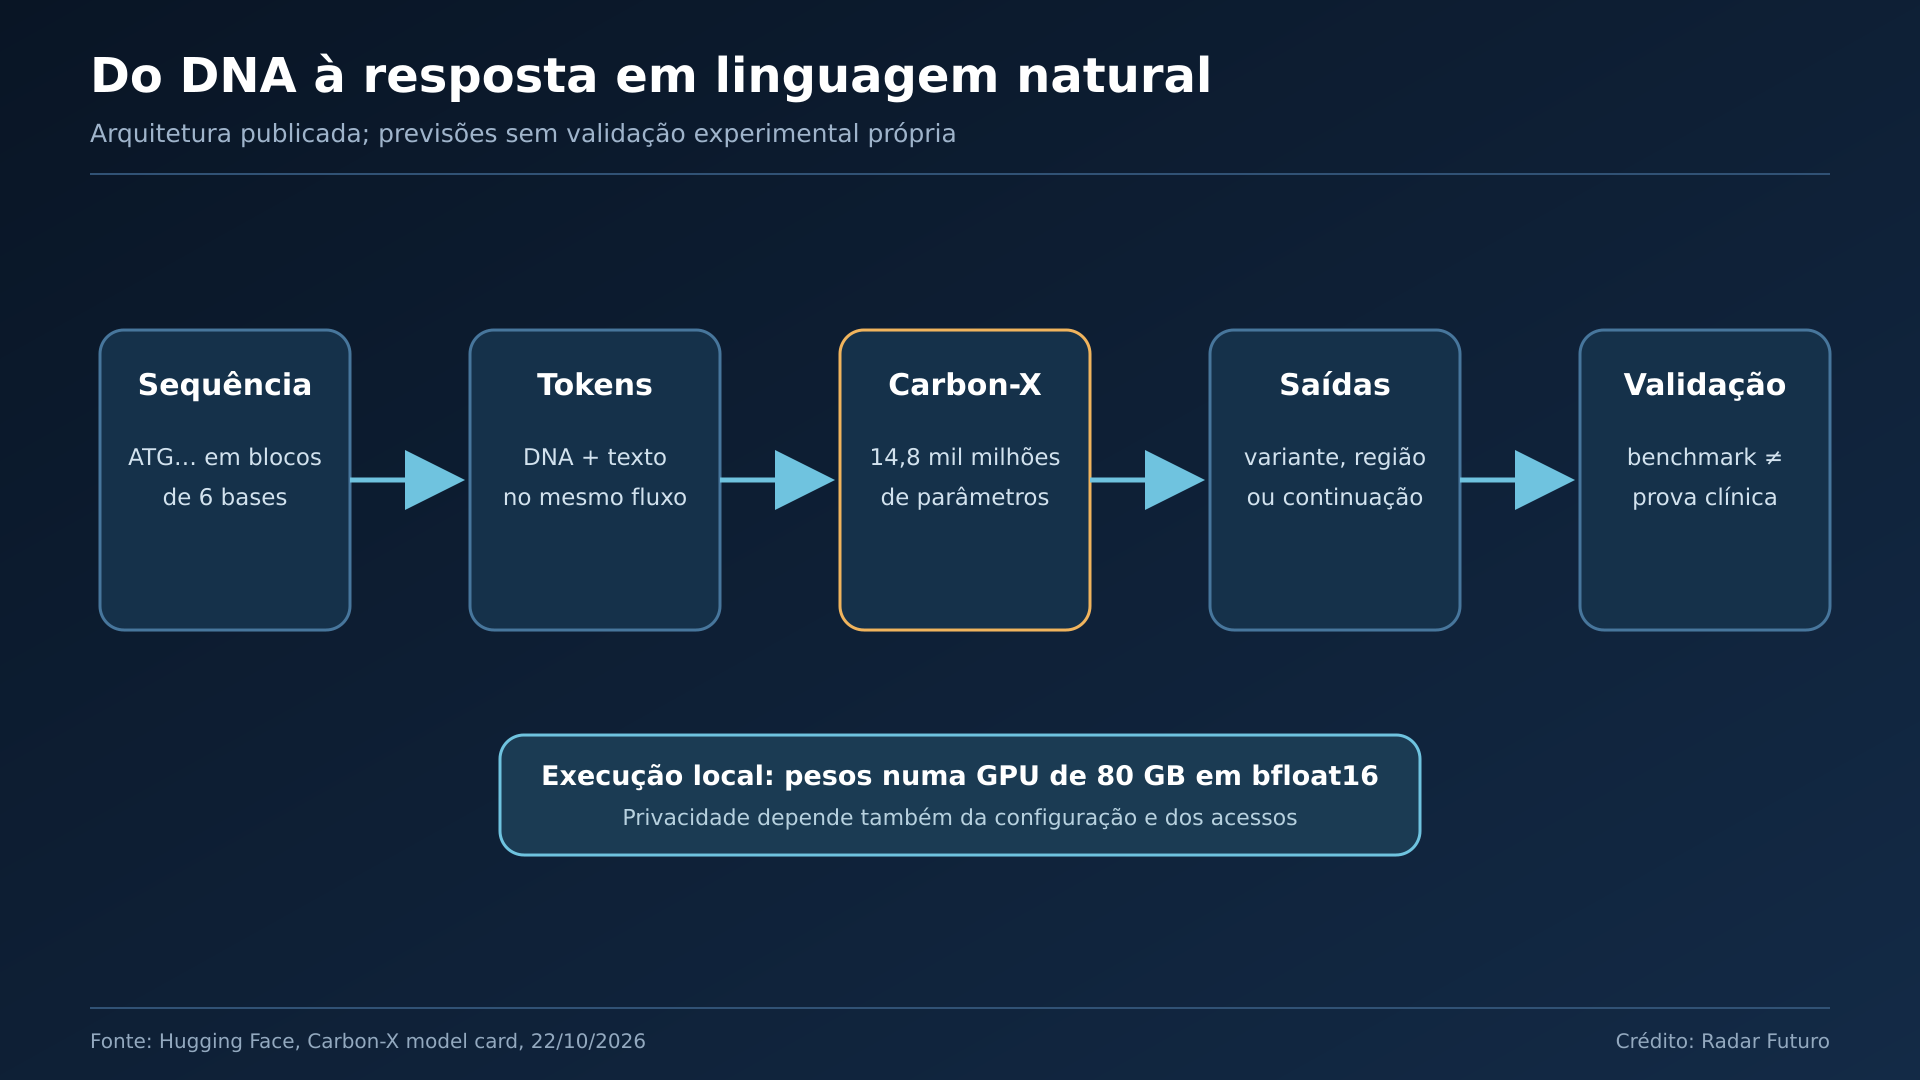
Um único fluxo para letras e bases
O modelo parte do Qwen3-14B e usa um único descodificador. O texto mantém a tokenização habitual; o DNA é dividido em grupos não sobrepostos de seis bases. Esta arquitetura evita um codificador genómico separado e permite que a resposta contenha linguagem natural e sequência genética no mesmo fluxo.
Segundo a documentação técnica, o treino intermédio usou 302 mil milhões de tokens, seguido de afinação supervisionada e aprendizagem por reforço em tarefas verificáveis. A janela de contexto é de 40 960 tokens. O modelo foi preparado para prever efeitos de variantes, reconhecer regiões reguladoras, classificar sequências e continuar DNA.
Resultados publicados pelo próprio projeto
Em cinco benchmarks, a equipa reporta uma média de 66,7% com o modo de raciocínio desligado. A comparação inclui modelos abertos e comerciais, mas foi desenhada e executada pelos criadores. Os resultados medem conjuntos de teste computacionais; não demonstram que uma previsão clínica esteja correta para uma pessoa.
Os pesos cabem, em precisão bfloat16, numa GPU com 80 GB de memória. Existem também quantizações para execução local. Manter sequências em infraestrutura própria pode reduzir a exposição de dados sensíveis, embora a privacidade continue dependente da configuração, registos, controlo de acessos e aplicações construídas em redor do modelo.
Onde termina a evidência
A equipa declara que as previsões ainda não foram validadas por experiências laboratoriais próprias. O Carbon-X deve ser tratado como ferramenta de investigação para priorizar hipóteses. Diagnóstico, aconselhamento genético e desenho terapêutico exigem validação independente, especialistas e métodos clínicos estabelecidos.
A contribuição imediata é tornar reproduzível um modelo multimodal de biologia fora de uma API fechada. Os próximos testes decisivos serão comparações independentes, estudos de robustez a populações pouco representadas e confirmação experimental das variantes classificadas.